
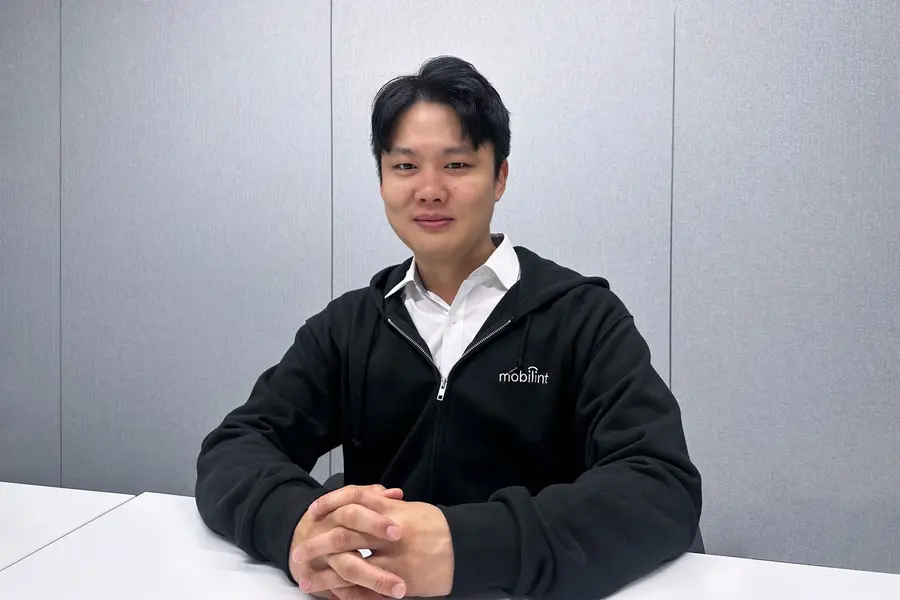
|스마트투데이=최아랑 기자| 신동주 모빌린트 대표는 “고객은 이번 달에 나온 최신 모델을 원한다”며 “제품을 테스트하는 동안에도 새로운 모델이 나오고 고객의 요구도 계속 바뀐다”고 말했다.
AI 반도체 팹리스 모빌린트는 자체 소프트웨어 개발도구(SDK) ‘qb’로 490개 이상의 AI 모델을 지원하며 그래픽처리장치(GPU) 대체 수요를 공략하고 있다. 스마트투데이는 1편에서 제품 공급 현황과 고객 도입 단계를 다룬 데 이어, 2편에서 고객 모델을 신경망처리장치(NPU)에서 구동하고 성능을 검증하는 과정을 살펴봤다.
최신 모델 지원하려면 변환·최적화 필요
모빌린트의 SDK ‘qb’는 고객이 개발한 AI 모델을 NPU에서 실행하도록 지원한다. 회사 자료 기준 지원 모델은 영상 분석과 음성인식, 자연어 처리 등을 포함해 490개 이상이다.
모델을 NPU에서 실행하려면 모델이 사용하는 연산을 확인하고, 반도체가 처리할 수 있는 형태로 변환·컴파일해야 한다. 고객이 모델을 직접 수정했거나 지원되지 않는 연산을 사용하면 추가 검증이 필요할 수 있다. 제품과 소프트웨어 환경에 따라 모델을 조정하거나 일부 연산을 다른 프로세서에서 처리하는 방안도 검토한다.
다만, 신 대표는 모든 최신 모델을 즉시 지원하기는 어렵다고 말했다. 고객이 검증 중 사용할 모델을 바꾸면 새 모델이 제대로 실행되는지, 처리 속도와 정확도가 서비스 기준에 맞는지 다시 확인해야 한다. 그는 “잘 지원되는 경우도 있지만 CPU나 GPU를 함께 쓰거나, 지원에 시간이 걸리거나, 다음 제품에서 지원해야 하는 경우도 있다”고 설명했다.
콜센터 음성인식으로 정확도·처리량 검증
모빌린트가 제시한 콜센터 음성인식 테스트에서 에리스 기반 가속기 카드 MLA100의 문자 오류율(CER)은 5.67%였다. 비교 대상으로 제시된 엔비디아 A40은 5.2%로, 차이는 0.47%포인트다.
회사는 두 제품의 차이가 NPU에 모델을 적용하는 경량화·양자화 과정에서 발생했다고 설명했다. 양자화는 연산 수치의 정밀도를 낮춰 계산량을 줄이는 방식으로, 인식 결과에도 영향을 줄 수 있다.
신 대표는 고객사가 제시한 정확도와 동시 처리량 기준에 맞춰 성능을 검증한다고 말했다. 회사 설명에 따르면 해당 테스트에서 동시 처리량은 고객 요구치의 약 두 배를 충족했고, 정확도도 요구 기준에 부합했다.
전력 효율은 가속기 카드의 소비전력만으로 판단하기 어렵다. 같은 작업을 처리하는 데 필요한 장비와 주변 시스템의 전력도 함께 살펴야 한다는 설명이다.
제품 도입 뒤 장기 공급·지원도 고려
고객사는 성능 검증과 함께 제품을 장기간 공급받을 수 있는지, 도입 뒤 기술지원이 이어지는지도 살핀다. 제품 단종 시점과 후속 지원 계획, 기존 GPU를 대체할 때 생길 수 있는 위험도 검토 대상이다.
신 대표는 “고객은 한 번 쓰고 말 것이 아니라 계속 써야 한다”며 “얼마나 긴 기간 동안 안정적으로 공급할 수 있는지도 질문하는 부분 중 하나”라고 말했다.
모빌린트는 고객의 모델과 서비스 환경에 맞춘 지원을 이어가고, SDK와 모델 지원 범위를 개선해 나갈 계획이다.

댓글 (0)
댓글 작성
댓글을 작성하려면 로그인이 필요합니다.
로그인하기